Los agentes en paralelo parecen productivos hasta que llega la factura
¿Cómo se decide qué trabajo vale la pena darle a un agente, y cómo se sabe que el resultado justifica el gasto en tokens? La respuesta de Maximillian Piras es que el gasto sigue siendo ingobernable hasta que quien compra tiene una forma familiar de juzgar el trabajo. En la matriz que esboza, llama principio y deja como punto de partida para pensar, las tareas útiles son aquellas cuyos pasos son lo bastante inciertos como para que un script no baste, y cuyo resultado es más barato de comprobar que de rehacer. A la comparación que falta la llama mouse power. La grabación se titula como una afirmación: un agente que no se puede medir es un agente que no se puede gestionar.
Abre esa afirmación en medio del hábito que genera la factura. Tras agradecer a la sala en World's Fair, dice que la charla trata de medir agentes con los modelos mentales que la gente ya usa. Un agente, en el trabajo que describe, es un trabajador impulsado por un modelo al que se puede enviar hacia un objetivo, a menudo varios a la vez, con el uso medido en tokens. Mientras habla, dice, sus propios agentes siguen en segundo plano. Su atención se queda en la charla. La de ellos va a las diapositivas, que él cree que necesitan trabajo. Un sistema de diseño ya está montado, la guía ya está escrita, y envía un agente a explorar el tratamiento tipográfico y la maquetación, y luego muchos a la vez, porque uno nunca basta y el plazo está cerca.
Dice que el mismo patrón es como trabaja él, y como trabaja buena parte de la sala. Cuando el foco principal es una sola cosa, se pone en marcha una flota en paralelo para la investigación que aún parece inacabada y las exploraciones de diseño que aún parecen dignas de probar. Se siente como sacar más de la hora, y es divertido, hasta que llega la factura. Entonces pregunta si esa secuencia valió los tokens, si hizo vibe coding demasiado a fondo —su forma de llamar a dejar sueltos a los agentes— y si estuvo haciendo token-maxing, gastando esas unidades medidas como si más de ellas fuera lo mismo que más avance. La pregunta a la que dice que dedicará la charla es cómo evaluar ese costo y cómo ayudar a los clientes a valorarlo. Dice que está enviando los agentes al tipo y a la maquetación, y espera que terminen antes del plazo. No informa un resultado de ellos.
La sala ya hace correr flotas. Quienes compran y con quienes habla siguen preguntando para qué sirven los agentes
Sitúa la pregunta en un año y medio como diseñador desde la fundación en una empresa de uso de computadora. La charla se presenta bajo Yutori. Los modelos de uso de computadora, tal como él los describe, aprenden a usar una computadora como lo haría una persona. El caso para ellos es el hueco en el que una API, una conexión directa entre programas, o MCP, el Model Context Protocol que permite al software entregar a un agente herramientas y datos, no puede suministrar la información. Se envía un agente y luego se extrae y se vuelve a dar forma a lo que antes era difícil de alcanzar. Llama a ese camino menos eficiente que una API o un MCP, y lo llama último recurso. Ese es su posicionamiento de producto. Enuncia la brecha de eficiencia sin una medición adjunta.
La imagen que pone en el escenario es un chiste: el agente de la empresa en el sitio de la propia empresa, mirando su propio benchmark y, como él lo dice, admirándose. Dice que se pone un poco raro, y sigue. El trabajo que de verdad describe es la conversación con clientes. Intenta aprender qué modelos mentales usa la gente cuando decide que un agente vale la pena enviarlo, y qué casos de uso quieren. Los clientes con los que habla están entusiasmados, y dice que muchos parecen confundidos hasta ahora. La frase que oye a menudo es que apenas están rascando la superficie. Todavía no se siente intuitivo cómo usar bien los agentes. Las preguntas se repiten: cuál es el mejor uso y cómo debe canjearse el costo en tokens frente al valor. Trata ese juicio como un músculo que la industria todavía está construyendo. Entusiasmo, confusión y rascar la superficie es lo que dice que oye de los clientes con los que habla. No está informando una encuesta, y no da un recuento de esas conversaciones.
Su tesis sigue en sus palabras. Los agentes tienen un problema de medición. La ilustración es un chiste: un compañero lo fotografió intentando medir agentes y dijo que parecía estar resolviendo el misterio de Pepe Silvia, un tablero de conspiración usado para hacer reír. Está de acuerdo en que la tarea es difícil, y luego representa la objeción que espera de la sala. Alguien ya tiene una flota en marcha, se siente bien midiéndola y está construyendo la siguiente aplicación mientras sigue la charla. Concede esa sensación. Luego señala una cita de Upton Sinclair y deja las palabras mismas sin pronunciar. El punto que extrae es que la sala es una muestra sesgada: adoptantes tempranos, entusiasmados con la tecnología, y un mal sustituto de las personas que esperan que la adopten más tarde. De algún modo, dice, la gente que está allí vende tokens, directa o indirectamente, así que su propio uso es una imagen débil de alguien que nunca ha tocado un agente. Algunas de esas personas siguen copiando texto a mano en ChatGPT. Dice que está casado con una de ellas, y que ella no le ha dejado configurarle agentes. Esa historia es un hogar.
El caballo de fuerza fue una comparación tosca que llevó a probar un motor a quien compraba pensando en caballos
Trata la adopción como un viejo problema de comunicación. Una tecnología nueva entusiasma, y quienes la venden aún no han encontrado la forma de decir cuánto vale. Para esta charla vuelve al siglo XVIII y a James Watt vendiendo máquinas de vapor. En este relato, el caso de uso de Watt era reemplazar el horse gin, la fuente de energía de un molino: un caballo enganchado a un brazo giratorio, caminando en círculo. El detalle de la cervecería, moler cebada, es uno que ofrece y enseguida debilita. Dice que no es persona de cervecería y que no sabe exactamente cómo funciona el proceso. El bosquejo es suyo, incluida esa incertidumbre. En aquella época, dice, el gin era corriente, y Watt pensaba que una máquina de vapor era una máquina mucho más eficiente.
La barrera que Watt reconocía, en el relato de Piras, era la disonancia cognitiva. A quienes compraban pensando en caballos se les pedía confiar en una máquina fría e intimidante, con alguien prometiendo que resolvería sus problemas antes de que pudieran ver el resultado. Dice que esa brecha debería sonar familiar a cualquiera que trabaje en agentes. La solución de Watt fue aprender el modelo mental de quien compra y hacer una métrica que pusiera una línea de base bajo la ganancia afirmada. Estudió horse gins, tomó lo que Piras llama mediciones de sillón de la mecánica y del rendimiento medio, y llegó al caballo de fuerza: una cifra de la potencia que producían los caballos y luego un multiplicador de lo que el motor podía aportar.
La lectura de Piras es que la métrica no era muy científica ni necesariamente exacta. Lo que hizo fue comunicar un aumento de valor. Quienes querían a los caballos podían estimar la ganancia lo bastante bien como para probar el motor. El trabajo del número era superar el obstáculo de probarlo, no predecir lo que quien compra obtendría una vez en uso. Luego hace el chiste que lleva la lección. La eficiencia estaba del lado de Watt, y los caballos seguían teniendo mejor ambiente, así que la métrica tenía que mover a quien compra del afecto a un cálculo del ROI, el retorno del dinero y del esfuerzo. Si no se puede dar al cliente un ROI tangible, dice, el valor es muy difícil de comunicar.
Un presupuesto de tokens, una tabla de clasificación y un gráfico de enrutamiento de modelos siguen sin alcanzar el resultado
Vuelve esa lección hacia la industria tecnológica. La gente de la sala puede tratar el ROI como resuelto. Dice que otros ingenieros, agudos en teoría y menos empapados de esta escena, todavía se gastan en un trimestre todo el presupuesto anual de tokens, o acaban conviviendo con tablas de clasificación de tokens. No nombra empresa, cifra de presupuesto ni fecha. De esas escenas concluye que los incentivos siguen desalineados y que el sector sigue sin la medida correcta del valor. El público más difícil, en su encuadre, es la persona que aún no comparte el vocabulario y que todavía necesita una imagen legible de la eficiencia que se supone que un agente añade.
El modo de fallo que quiere romper es un ciclo de gastar de más y usar de menos. Toma el término de Ramp, y dice que Ramp tiene una entrada de blog al respecto. Tal como describe el ciclo, la gente se lleva el token-maxing hasta la austeridad, se baja y vuelve cuando el FOMO, el miedo a quedarse fuera, es lo bastante fuerte para empezar de nuevo. Mejores medidas del valor son, dice, el modo de romper el ciclo. La publicación está presente solo como ese resumen de escenario.
También describe un gráfico que el director ejecutivo de Coinbase publicó en X. En el mismo relato dice que en realidad no habían empezado a cambiar los valores por defecto de con qué modelo empieza la gente, que intentaban reservar los modelos de frontera para las tareas más difíciles y que, como resultado, el gasto en IA empezó a separarse del uso de tokens. Lo llama un buen comienzo, vuelve a la publicación de Ramp y dice que el problema sigue siendo que esto está demasiado centrado en los tokens. No adjunta porcentajes. El momento se queda en recientemente.
Su estándar está un paso más allá del recuento de tokens. Los tokens son una medida útil dentro de un sistema, y siguen siendo solo un producto. Quiere que se tracen con limpieza hasta un resultado: cuántos bugs se aplastaron con el gasto, cuántas solicitudes de soporte se cerraron, y luego esos resultados atados al avance en los objetivos. Sin una medida ajustada del ROI, dice, esa cadena es muy difícil de trazar. Los bugs y los tickets se quedan como ejemplos del tipo de resultado que quiere decir. No ofrece fórmula ni un caso con resultados.
Programar más rápido trasladó la restricción a la revisión humana
Luego dice que la misma fuga ya está en la sala. La gente disfruta programando con agentes y, como él lo pone, siente un aumento de capacidad y de eficiencia. También, en su frase, está muriendo por mil pull requests. Un pull request es un cambio de código propuesto que espera a una persona. Dice que algunas personas sin nombre del equipo de Anthropic han afirmado que programar está resuelto y también han admitido que la revisión de código no lo está. Él es diseñador desde la fundación en la empresa que el título presenta como Yutori, así que el comentario es su informe sobre personas del equipo de Anthropic, y no llega a una posición de la empresa Anthropic.
La consecuencia que extrae es que el cuello de botella se ha movido a la revisión humana. La ganancia que la gente siente al generar código todavía no se ve en el trabajo que se entrega, porque la mayor parte del tiempo va a la revisión, y la revisión no ha escalado junto con la generación. La verificación es donde se sienta la restricción, así que el valor es difícil de medir a la velocidad a la que aparece el código, y la calidad es difícil de juzgar a esa velocidad. El cálculo del ROI se atasca entonces de una forma concreta: un equipo puede generar muchísimo código y seguir sin un modo de saber que bastante de ese código es lo bastante bueno para justificar el gasto.
Admite que la revisión de código quizá ya tuviera fallos, y que los agentes ahora los están dejando al descubierto. Cita a Noah Hein, a partir de una publicación sobre resolver la revisión de código, y resume el punto en lugar de leerlo en voz alta. Lo que ahora hay que revisar son los supuestos que están debajo de la revisión de código, y hay que comprobar los supuestos previos antes de que alguien pueda poner una base nueva para la revisión en la era de los agentes. Dice que le gusta el punto, y luego declina el encargo. Resolver la revisión de código, dice, es otra charla para otra persona.
Lo que se queda es por qué la revisión parece resoluble. Como cultura, la revisión de código ya converge en supuestos compartidos, y esa convergencia es lo que permite que una medición se vuelva una rúbrica. La tarea ahora es adaptar esos supuestos a los agentes, para que la ejecución a velocidad de computadora pueda ir acompañada de medición a velocidad de computadora, y para que las mediciones encajen en los modelos mentales de los clientes que las usan. La lección que enuncia es que construir un agente incluye un método para que el cliente verifique que el resultado es bueno, y un camino hacia un ROI lo bastante claro para justificar el gasto.
Mouse power es una base que quien compra puede reconocer, y el medidor de velocidad del puntero es un chiste
Mouse power es el nombre que le da a ese trabajo, ofrecido como el caballo de fuerza de la era de los agentes. Watt podía mostrar un múltiplo de eficiencia frente a los caballos del gin. Piras quiere una línea de base de cómo usa la gente las computadoras hoy, y luego una demostración de los vectores en los que un agente rinde más en la misma tarea. Dice que el trabajo es más difícil que el de Watt. No hay una sola máquina junto a la cual ponerse a cronometrar.
Tiene un chiste listo para la lectura literal. Dice que hizo que Claude construyera con vibe coding un aparato de medición, con la idea de que cronometrar lo rápido que un puntero puede cruzar la pantalla podría dar una medida limpia de mouse power. Luego dice que solo bromea. El movimiento del puntero es un esfuerzo inútil, porque el espacio de información tiene demasiadas dimensiones para capturarlo así. Mouse power, dice, no va a ser nunca una métrica. Es una idea.
La idea, para quien vende un agente, es que la venta incluye una rúbrica que quien compra puede usar para verificar que el trabajo es bueno y, por tanto, que los tokens valen la pena. Cómo construir la rúbrica queda en manos de quien lo construye. Dice que no podrá decirle a la sala cómo, y que no tiene un buen marco para elegir las mediciones. El principio es la parte que está dispuesto a dar.
Elija tareas cuyo camino sea lo bastante incierto para necesitar un agente y cuyo resultado sea barato de comprobar
El principio de trabajo que ha estado dando vueltas viene de Claude Shannon. La entropía, en la glosa que da, es la incertidumbre de una distribución de probabilidad. Dice que esa idea es en muy buena medida la base de cómo se entrenan hoy los agentes, y que la entropía cruzada es un factor grande de lo capaz que llega a ser un agente. Quiere la misma palabra apuntando a la tarea, no solo a lo capaz que es el agente. La charla se queda en esa glosa.
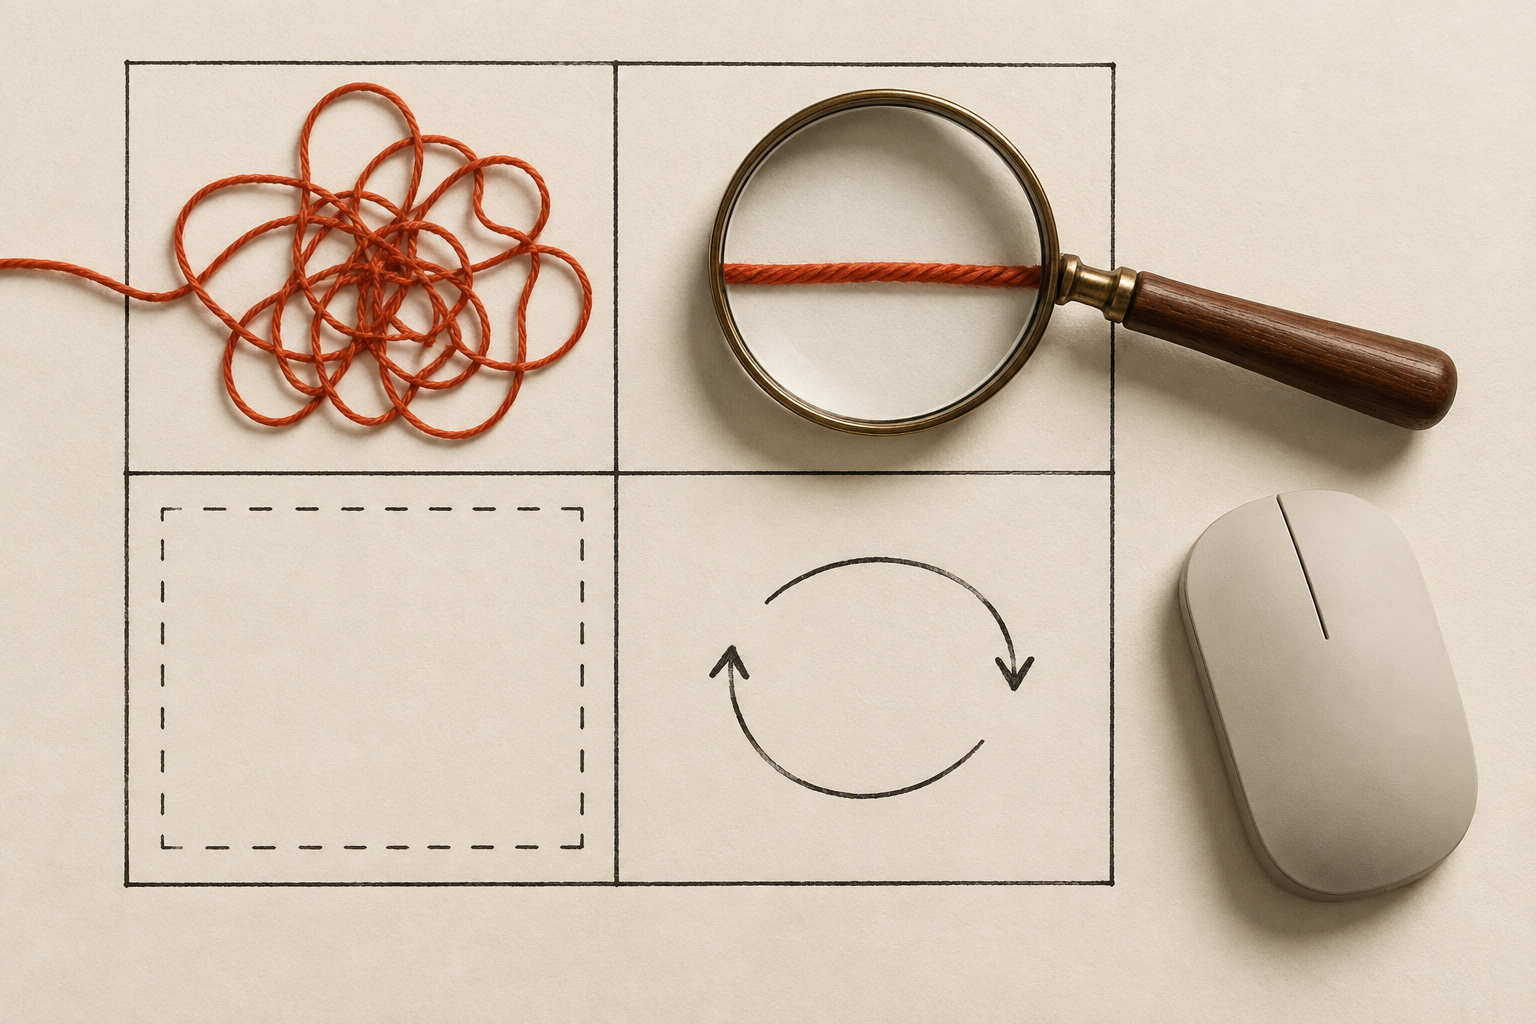
Tiene una matriz. Un eje es la incertidumbre de los pasos. Reservar un vuelo se sitúa hacia el extremo bajo, porque una compra tiene sucesos obligados: un lugar de salida, un lugar de llegada y un asiento, elegido por quien viaja o asignado. Pintar una obra maestra se sitúa en el extremo alto. Dice que quién sabe los pasos, y que un camino relativamente predecible sería muy difícil de trazar. Aun así, un agente podría apuntar al cuadro. El otro eje es la incertidumbre de los criterios de aceptación, la rúbrica para calificar el resultado. No basta con que un agente pueda realizar la tarea. Alguien necesita una forma limpia de calificarla. Dice que la intersección guía mejor qué construir que preguntar solo si la tarea sería valiosa. Los ejemplos y las reglas que enuncia son la parte que quien escucha puede reutilizar.
Sobre la incertidumbre de los pasos, un camino predecible recibe una instrucción seca: sáltese los tokens y escriba un script. Una incertidumbre muy alta significa información impredecible. Llama a eso una mala tarea para un agente. Es probable que quede fuera de la distribución del preentrenamiento, es decir, distinta de los datos de los que aprendió el modelo, y es probable que ofrezca recompensas escasas, una señal rara de éxito, en el aprendizaje por refuerzo. Aprendizaje por refuerzo aquí significa aprender a partir de señales de recompensa. En esa región, dice, los datos son mucho más difíciles de modelar. Al volverse hacia el gráfico confunde el lado izquierdo y el derecho del escenario, y dice que quien habló antes se confundió con lo mismo. Las etiquetas del gráfico solo se dicen en parte. Cuando llega al medio ya se le pasó el tiempo. Dice que no le han hecho señas para que baje, y termina rápido. El medio, al que llama el punto dulce, es la franja con incertidumbre suficiente para ser interesante: más abierta que un script, y todavía dentro de lo que el entrenamiento puede alcanzar.
Los criterios de aceptación cortan esa franja. Una incertidumbre alta ahí significa que la verificación no se distingue de la ejecución. Para saber que el resultado fue útil, una persona tiene que hacer el trabajo otra vez, y los tokens se desperdiciaron. Lo que deja en el medio es una tarea con incertidumbre suficiente para quedarse fuera de un script, todavía entrenable y relativamente fácil de validar. Compara esa forma con un problema de estilo NP, con lo que quiere decir más fácil de verificar que de ejecutar. El parecido es sobre la forma del trabajo. Si la comprobación es un patrón repetible, dice, también se puede enviar un agente a la comprobación. Se construye el agente que hace el trabajo y el agente que lo verifica.
Llama a la matriz un punto de partida para pensar, todavía en obra, e invita a la crítica. La esperanza con la que cierra es que quien construya el siguiente agente construya también su mouse power: el patrón de verificación que hace juzgable el gasto.
| Qué se sabe de la tarea | Qué dice que hay que hacer |
|---|---|
| Los pasos ya son predecibles, como al reservar un vuelo que debe incluir una salida, una llegada y un asiento | Escriba un script y sáltese los tokens |
| Los pasos son extremadamente inciertos, como al pintar una obra maestra, donde dice que un camino predecible sería muy difícil de especificar | Trátela como una mala tarea para un agente: probablemente distinta de los datos de preentrenamiento, con señales de recompensa escasas en el aprendizaje por refuerzo |
| Los criterios de aceptación son tan inciertos que comprobar el resultado significa hacer el trabajo otra vez | Sáltese el agente. Una persona tendría que rehacer el trabajo, y los tokens se desperdician |
| El camino tiene alguna incertidumbre, la tarea sigue pareciendo entrenable y una comprobación repetible es más fácil que el trabajo | El punto dulce que nombra: un agente trabajador, más un segundo agente que lo verifica |
Lo que quien programa puede aplicar mientras el marco sigue sin terminar
Su matriz sigue siendo un punto de partida para pensar, y la regla de clasificación que hay dentro ya se puede usar. Antes de la próxima ejecución en paralelo, escriba el camino. Un camino que ya es predecible pertenece a un script. Si la única forma de saber que el resultado es bueno es rehacer la tarea, déjesela a una persona. Donde el camino tiene alguna incertidumbre, la tarea sigue pareciendo entrenable y una comprobación repetible es más fácil que el trabajo, su sugerencia es un agente trabajador más un agente verificador. Ya ha nombrado los resultados que harían legible el gasto: bugs aplastados o solicitudes de soporte cerradas, y luego el avance en el objetivo que se supone que esas cuentas deben mover.
Use esa regla con los límites que él le dejó. La matriz está inacabada. Se le acabó el tiempo cuando nombró el punto dulce, y pidió a la sala que discutiera con él. Mouse power es un nombre que acuñó para una comparación que quien compra podría reconocer. El medidor de velocidad del puntero es un chiste que cuenta contra tratar ese nombre como una unidad que se puede cronometrar. Las frases de los clientes son lo que dice que oye en la conversación: entusiasmo, confusión y rascar la superficie. No ofrece una encuesta. La afirmación de que programar está resuelto, y de que la revisión de código no, es su informe sobre personas sin nombre del equipo de Anthropic, y no llega a una posición de la empresa. Describe su propio trabajo como diseñador desde la fundación en la empresa que el título del video presenta como Yutori. Nombra a Noah Hein y resume una publicación sobre revisión de código sin leerla en voz alta. El ciclo de Ramp y el gráfico de Coinbase son descripciones de escenario sin cifras. Sobre el gráfico, dice que en realidad no habían empezado a cambiar con qué modelo empieza la gente, y también dice que el gasto en IA se separó del uso de tokens como resultado. El horse gin, cervecería incluida, es su bosquejo, y dice que no está seguro de cómo funciona la elaboración. El uso de computadora, en su planteo, es el último recurso menos eficiente cuando una API o MCP no puede suministrar la información, y no adjunta una medición a esa brecha. La pieza que quiere que se construya a continuación es la verificación que quien compra puede reconocer. Esta charla no convierte mouse power en una unidad de trabajo.
Fuente
También de
Fuentes y criterio editorial
Este artículo sigue los subtítulos en inglés de la charla de Maximillian Piras «Mousepower: agents that can't be measured, can't be managed», publicada en el canal de YouTube de AI Engineer el 10 de septiembre de 2026. Esa fecha es la de publicación. Agradece a un público de World's Fair y no fecha el evento. Yutori es la empresa que aparece en el título del video. El nombre de empresa que pronuncia no queda claro en los subtítulos. James Watt, la publicación de Ramp, el gráfico de Coinbase y la publicación sobre revisión de código aparecen solo tal como él los describe en el escenario. No se usó ninguna página de historia, página de empresa ni prueba de producto. Comprobado el 2 de octubre de 2026.