La respuesta corta: dale los datos al modelo y convierte el renderizado en un paso aparte
Supongamos que gestionas un servidor MCP y quieres que tus resultados aparezcan en Claude o ChatGPT como una interfaz real y no como texto plano. ¿Cómo consigues que el modelo pueda ver esos resultados, razonar sobre ellos y seguir buscando, en lugar de mostrar un carrusel y detenerse? Primero, algunos términos. MCP, el Model Context Protocol, es una forma de que los clientes de chat con IA llamen a herramientas externas. Un servidor MCP es el servicio que ofrece esas herramientas. MCP Apps, y el Apps SDK de OpenAI para ChatGPT, permiten que una herramienta devuelva una interfaz interactiva, llamada widget, que aparece dentro de la conversación.
Dustin Mihalik, de Indeed, responde con tres reglas. Primera: todo lo que el usuario ve en el widget también debe llegar al modelo como datos. Segunda: todo lo que el usuario hace en el widget debe comunicarse al modelo. Tercera: obtener datos y dibujar la interfaz deben ser tareas de herramientas distintas, para que el modelo pueda buscar tantas veces como exija la tarea y elegir qué mostrar solo al final. Según él, la tercera regla prevalece sobre las otras dos. Además, es la única que ataca el problema de que el modelo se rinda tras una sola búsqueda.
Dio la charla en una sesión de AI Engineer, y la grabación se publicó en el canal de YouTube de AI Engineer. La grabación no indica cuándo tuvo lugar la sesión.
De dónde salen las lecciones
Mihalik cuenta que trabaja en la búsqueda de empleo de Indeed y también en un equipo de plataforma de IA que se ocupa de guardrails, gateways y cumplimiento normativo. Según él, ese equipo ya tenía relación con los proveedores de IA, y así acabó construyendo conectores MCP y apps MCP.
Según su relato, Indeed ha creado servidores y apps MCP para Claude, para ChatGPT y para Career Scout, que él describe como el agente propio de Indeed para personas que buscan empleo. No habla de fechas de lanzamiento ni de disponibilidad. Presenta la sesión como «lecciones desde las trincheras» (lessons from the trenches) y no como una introducción, y dice que una introducción anterior ya había cubierto los fundamentos de las apps MCP.
Por qué un portal de empleo quiere una interfaz dentro del chat
Empieza con una respuesta en texto plano de Claude a una búsqueda de empleos de barista en Austin. Dice que la respuesta es útil: Claude agrupa los empleos de la ciudad y de los suburbios cercanos. Pero nada indica que los resultados vienen de Indeed, y el editor apenas tiene control sobre lo que aparece.
Los enlaces son un problema mayor. Mihalik dice que cuesta conseguir que Claude o ChatGPT enlacen hacia fuera de forma consistente. Supone que se debe a que las plataformas prefieren que los usuarios se queden dentro del chat, aunque es una conjetura suya, no algo que demuestre. Una lista de empleos sin enlaces es una mala experiencia, dice. Su equipo dedicó lo que él llama una cantidad ridícula de horas y de evals (ejecuciones automatizadas que prueban el comportamiento del modelo) hasta que Claude enlazó de forma fiable. No dio cifras.
Según su relato, un widget cambia esto. Indeed puede poner un botón de solicitud en cada resultado y elegir qué campos aparecen arriba. También puede añadir un control de «ver detalles» que abre una ventana emergente, o modal, con la oferta completa, de modo que el usuario nunca sale del chat. Lo describe como un beneficio mutuo para Indeed y para la plataforma de chat. Mostró el widget en pantalla; esta descripción se basa en lo que dijo sobre él.
La adaptación ingenua: el widget se convierte en una caja negra para el modelo
El atajo tentador es tratar una app MCP como una forma de meter tu web en el chat. El widget carga algo de HTML, ese HTML llama a las API que tu web ya usa, y listo. Mihalik dice que no es tan fácil, y que ha visto apps MCP construidas exactamente así.
El problema es lo que sabe el modelo. El modelo llama a la herramienta, la herramienta pone los resultados en pantalla y el modelo no tiene ni idea de cuáles son. Entonces fallan peticiones de seguimiento corrientes como «háblame del primer resultado» u «ordena estas empresas». Los datos fueron directamente de tu API al widget y nunca pasaron por el modelo.
Regla uno: lo que ve el usuario, el modelo lo recibe como datos
Su primera regla es que toda la información que se muestra en la interfaz también debe entregarse al modelo como datos.
Tal como él describe las especificaciones de MCP y MCP Apps, una respuesta de herramienta contiene dos cosas. La primera es el contenido estructurado (structured content): el resultado legible por máquina que lee el modelo, lo mismo que ya devolvería una herramienta MCP solo de texto. La segunda es un URI de recurso, un puntero que el cliente de chat usa para cargar el HTML del widget. Hay que devolver ambos, y según él hay que mantenerlos sincronizados. Si la API que hay detrás del widget incorpora un campo nuevo, como un rango salarial, el contenido estructurado que lee el modelo debería incorporar el mismo campo. De lo contrario, el usuario puede ver algo de lo que el modelo no puede hablar.
Evitar que el modelo repita lo que el widget ya muestra
La regla uno tiene un efecto secundario. En cuanto el modelo tiene los datos, hace lo mismo que con cualquier salida de herramienta y escribe la lista completa de resultados como texto, justo debajo del widget que ya la muestra. El usuario lo ve todo dos veces.
Su solución es una línea al principio de la descripción de la herramienta, el texto que el modelo lee para decidir cómo usarla. Esa línea indica que los resultados se mostraron automáticamente al usuario como componentes de interfaz. Con ella, dice, el modelo escribe un breve resumen y deja el listado al widget. Describe una especie de pulso entre lo que muestra la interfaz y lo que escribe el modelo, y afirma que esta única línea «cubre bastantes de los casos».
Regla dos: dile al modelo qué ha pulsado el usuario
El widget puede ocultar información de otra manera. Supongamos que una búsqueda devuelve diez empleos y el usuario abre los detalles de uno. El modelo no sabe cuál. Entonces falla una petición como «escribe una carta de presentación para este empleo» o «resume esta descripción del puesto», porque la oferta completa se cargó en el widget y nunca se le mostró al modelo.
La regla de Mihalik es que la información sobre lo que hace el usuario en el widget también debe enviarse al modelo. Nunca dice «regla dos» en voz alta, pero ocupa el segundo lugar en su secuencia, y más adelante llama regla tres a la separación entre datos y renderizado.
Dice que MCP Apps ofrece un método para esto, al que llama update model context. Según él, recibe una sola cadena, así que si quieres informar de varios eventos a lo largo del tiempo tienes que ir añadiéndolos a esa misma cadena. Menciona lo que describe como un ejemplo de carrito de la compra en la documentación de MCP Apps. Esa app pasa al modelo los artículos del carrito y el coste total, para que el usuario pueda hacer preguntas sobre su carrito.
El punto de inflexión: una herramienta con interfaz corta la búsqueda en varios pasos
Con las reglas uno y dos aplicadas, el modelo puede ver más o menos lo que pasa. Mihalik dice que la app sigue sin ser buena, porque la gente no le lleva a Claude problemas fáciles. Si solo quisiera una búsqueda, dice, iría a la web. A Claude le lleva los difíciles.
Su ejemplo es un usuario dispuesto a mudarse. Quiere buscar un mismo puesto en muchas ciudades, quedarse con las opciones mejor pagadas y excluir ciertos sectores. Con una herramienta de búsqueda MCP de texto plano, dice, Claude lo resuelve bien. Hace unas 10 o 15 búsquedas, las filtra, extrae los detalles relevantes y termina con una tabla resumen. La cifra es un ejemplo aproximado, no un benchmark.
Ahora haz que esa herramienta de búsqueda también renderice un widget, con una descripción que diga que los resultados se muestran al usuario. Mihalik dice que Claude la llama una vez y se detiene, aparentemente porque concluye que los resultados ya están en pantalla y no hace falta indagar más. Añade una razón práctica: nadie quiere diez carruseles seguidos, y Claude parece darse cuenta de que ya ha mostrado algo. Así, la interfaz que debía mejorar la experiencia corta el trabajo en varios pasos que los usuarios querían. Lo presenta específicamente para Claude, como una observación de su equipo.
Regla tres: separar el procesamiento de datos del renderizado de la interfaz
La tercera regla de Mihalik es separar el procesamiento de datos del renderizado de la interfaz, y dice que prevalece sobre las otras dos. Afirma que tomó la formulación de la documentación del Apps SDK de OpenAI, que según él la recoge en un par de lugares.
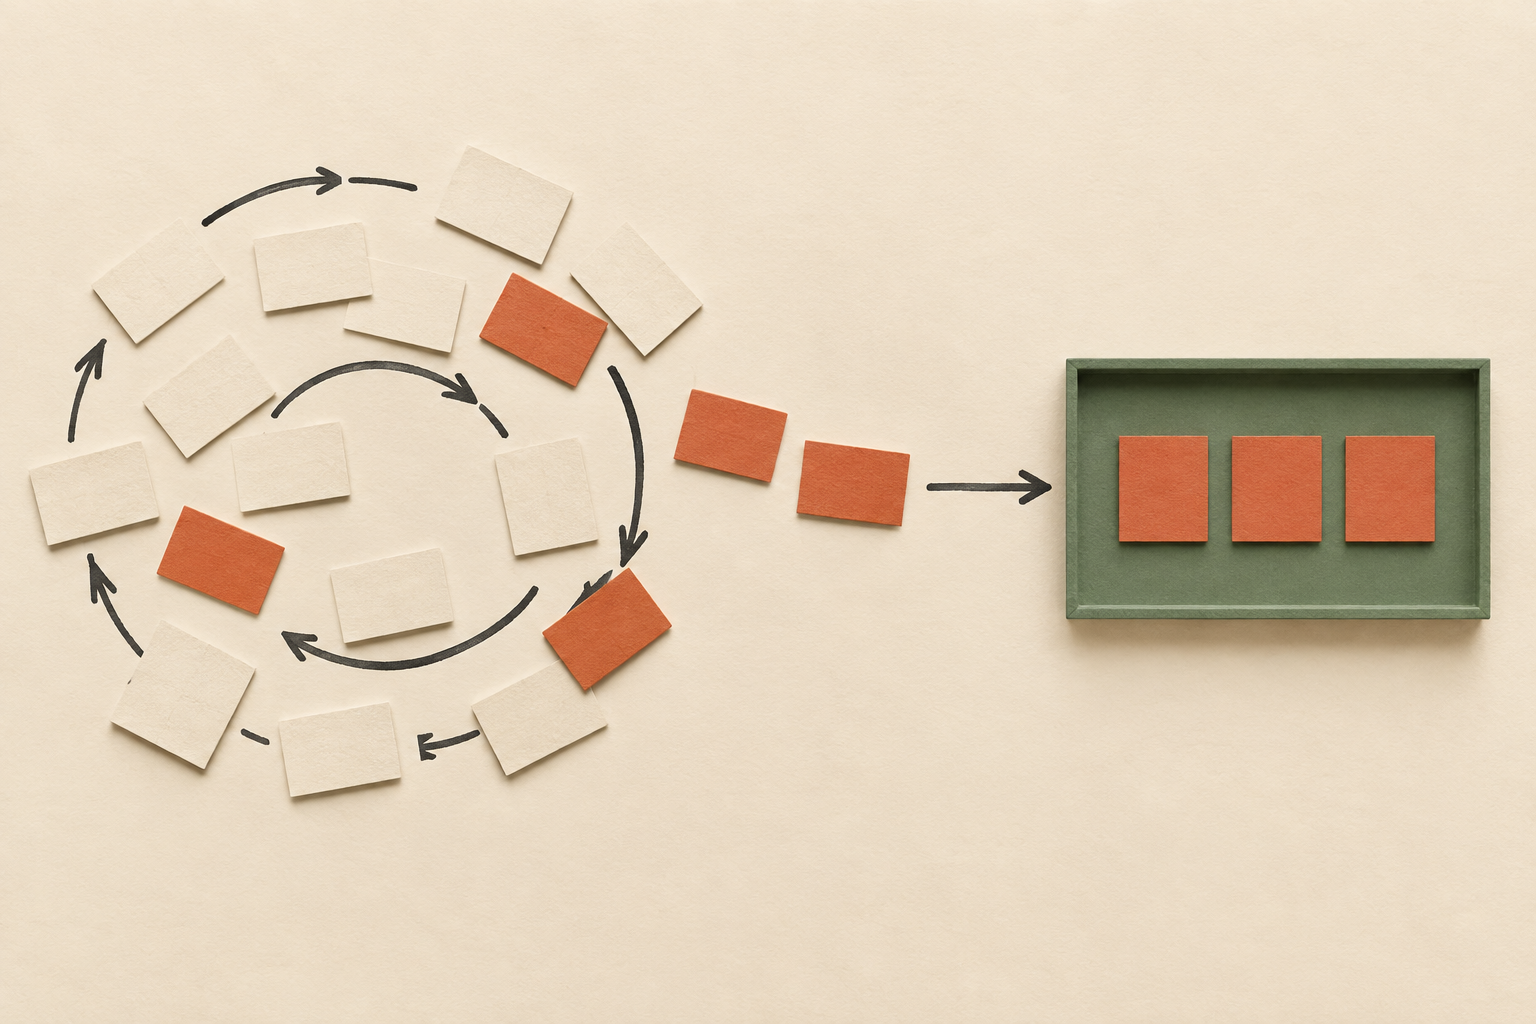
La versión de Indeed funciona así. La herramienta que él llama search jobs pasa a ser una herramienta MCP estándar, solo de texto y sin interfaz, y Claude puede llamarla tantas veces como quiera. Un widget aparte, render-jobs, recibe una lista de ID de ofertas. Claude puede buscar, reunir unos cien empleos candidatos, filtrarlos hasta dejar cinco y pasar solo esos cinco ID a la herramienta de renderizado. El usuario ve entonces un único widget con la selección del modelo. La cifra de cien a cinco es un ejemplo suyo.
Dice que una herramienta de renderizado puede recibir o bien todos los datos que el modelo quiere mostrar, o bien referencias a ellos. Indeed eligió referencias, es decir, ID. En cualquier caso, la descripción de la herramienta de renderizado tiene que explicar de dónde vienen los datos y en qué formato deben estar, y decir que primero hay que llamar a una de las herramientas de datos para obtenerlos. Lo describe como un cambio bastante sencillo en las descripciones de las herramientas.
| Una herramienta que busca y renderiza | Herramienta de búsqueda de texto + herramienta de renderizado aparte | |
|---|---|---|
| Cuántas veces busca el modelo | Una vez, según su relato. Trata los resultados mostrados como la respuesta final | Tantas como exija la tarea. Describe 10–15 búsquedas para una petición en varias ciudades |
| Qué puede ver el modelo | Los datos devueltos, si se sigue la regla uno | Cada resultado de búsqueda como datos, antes de que se muestre nada |
| Qué ve el usuario | Un widget construido a partir de una sola consulta | Un widget con la selección que eligió el modelo (su ejemplo: unos 100 candidatos reducidos a cinco) |
| Qué recibe el paso de renderizado | Lo que haya devuelto la única consulta | Una lista de ID de ofertas elegidos por el modelo |
La misma separación en otros ámbitos, y herramientas de renderizado que transmiten el razonamiento del modelo
Mihalik dice que la mayoría de los sectores pueden encontrar una separación parecida: dejar que el modelo explore los datos y luego que elija qué renderizar. Menciona resultados de productos en comercio electrónico y un widget de mapa que recibe cinco direcciones elegidas por el modelo.
Después sugiere que las herramientas de renderizado pueden recibir algo más que ID. En las respuestas solo de texto, señala, los modelos suelen explicar por qué eligieron cada resultado. Una herramienta de renderizado podría aceptar un ID más un motivo breve de por qué encaja el empleo, o un ID más un pasaje destacado de la descripción del puesto. Así, el razonamiento del modelo aparecería dentro del widget en lugar de en un texto aparte. Dice que Indeed «potencialmente» podría añadirlo, así que son ideas de diseño, no funciones que Indeed haya lanzado.
Lista de comprobación de diseño para tu propia app MCP
Mihalik cierra con dos conclusiones. La primera es resolver los datos antes que la interfaz. Admite que esto va en contra de la visión habitual de las apps MCP como una forma de meter interfaz en ChatGPT. Decide qué datos debe tener el modelo y qué debe poder hacer con ellos, y deja que el renderizado se derive de la exploración de esos datos por parte del modelo. La segunda es construir herramientas pequeñas y combinables. Su ejemplo son dos o tres herramientas de búsqueda para distintas formas de encontrar empleo, más una o dos herramientas de renderizado, quizá una para una lista de empleos y otra que destaque un único empleo. Cada una lleva una descripción sencilla, para no saturar al modelo y que aun así pueda elegir cómo explorar y qué mostrar.
En conjunto, sus consejos se resumen en una breve lista de comprobación para quienes desarrollan.
- Paridad de datos: todo lo que muestra el widget también debe volver al modelo como datos estructurados, y ambos deben mantenerse sincronizados.
- Orientación mediante la descripción: indica en la descripción de la herramienta que los resultados ya se muestran, para que el modelo los resuma en lugar de repetirlos.
- Contexto de interacción: comunica al modelo los clics y selecciones dentro del widget, para que las peticiones de seguimiento tengan sentido.
- Separación entre datos y renderizado: convierte la búsqueda en una herramienta solo de texto que el modelo pueda llamar muchas veces, y renderiza solo la selección final mediante una herramienta aparte cuya descripción indique qué herramienta de datos hay que llamar primero.
Lo que aún no está demostrado
Se trata de la experiencia de un equipo en una charla de unos 15 minutos, sin métricas, sin resultados de evals, sin cifras de antes y después y sin turno de preguntas. Sus afirmaciones sobre cuándo deja de buscar Claude son observaciones del comportamiento del modelo. Pueden cambiar con modelos más nuevos y quizá no se cumplan en ChatGPT u otros clientes, que no describió de la misma manera.
Los términos de la especificación, el método update model context y su limitación a una sola cadena, y los ejemplos de la documentación proceden de su descripción. No los hemos contrastado con la documentación de MCP Apps ni del Apps SDK, ni hemos construido una app para reproducir el comportamiento. Confirma los nombres exactos de campos y métodos en la documentación actual y trata la lista de comprobación como un punto de partida bien argumentado que probar en tu propio servidor, no como una receta demostrada.
Fuente
También de
Fuentes y criterio editorial
Leímos completos los subtítulos en inglés generados automáticamente de la grabación de AI Engineer, de unos 15 minutos, desde la presentación del ponente hasta las palabras de cierre. No hay turno de preguntas. Las diapositivas y capturas de pantalla no estaban disponibles y solo se describen a partir de lo que el ponente dijo en voz alta. Los fragmentos de subtítulos confusos se interpretaron de forma conservadora o se omitieron. No se consultó documentación oficial de MCP, MCP Apps ni del OpenAI Apps SDK, y no se construyó ni se probó ninguna app MCP para este artículo.