简短的答案:把数据交给模型,把渲染变成单独的一步
假设你运营着一个 MCP 服务器,希望搜索结果在 Claude 或 ChatGPT 中以真正的界面呈现,而不是纯文本。怎样才能让模型看到这些结果、据此推理并继续搜索,而不是展示一个轮播卡片就停下?先说明几个术语。MCP(Model Context Protocol,模型上下文协议)是 AI 聊天客户端调用外部工具的一种方式。MCP 服务器就是提供这些工具的服务。MCP Apps 以及 OpenAI 面向 ChatGPT 的 Apps SDK 允许工具返回一个出现在对话中的交互式界面,称为小组件(widget)。
Indeed 的 Dustin Mihalik 用三条规则来回答。第一,用户在小组件里看到的一切,也应该以数据形式传给模型。第二,用户在小组件里的一切操作,都应该回报给模型。第三,获取数据和绘制界面应该由不同的工具负责,这样模型可以按任务需要搜索任意多次,最后再选择要展示什么。他说第三条规则优先于另外两条。这也是唯一一条针对“模型搜索一次就放弃”问题的规则。
他是在 AI Engineer 的一场分享中做的这次演讲,录像发布在 AI Engineer 的 YouTube 频道上。录像中没有说明这场分享是何时举行的。
这些经验从何而来
Mihalik 说,他负责 Indeed 的职位搜索,同时也在一个 AI 平台团队工作,该团队负责护栏(guardrails)、网关和合规。他说这个团队与各家 AI 厂商本来就有合作关系,因此开始构建 MCP 连接器和 MCP 应用。
据他介绍,Indeed 已经为 Claude、ChatGPT 以及 Career Scout 构建了 MCP 服务器和应用;他将 Career Scout 描述为 Indeed 面向求职者的自有智能体。他没有谈及上线时间或可用情况。他把这次分享定位为“来自一线的经验”(lessons from the trenches),而非入门介绍,并表示此前的一场入门分享已经讲过 MCP 应用的基础知识。
招聘网站为什么想在聊天里放 UI
他先展示了 Claude 对“奥斯汀咖啡师职位”搜索给出的纯文本回答。他说这个回答是有用的:Claude 把市区和周边郊区的职位分组列出。但回答里没有任何标记表明结果来自 Indeed,发布方对显示内容也几乎没有话语权。
链接是更大的问题。Mihalik 说,很难让 Claude 或 ChatGPT 稳定地给出外链。他猜测原因是平台更希望用户留在聊天里,不过这只是他的猜测,并没有给出依据。他说,一份没有链接的职位列表体验很差。他的团队花了他所说的多到离谱的时间和 eval(对模型行为的自动化测试)才让 Claude 可靠地给出链接。他没有给出具体数字。
按他的说法,小组件改变了这一点。Indeed 可以在每条结果上放一个申请按钮,并选择哪些字段显示在顶部。它还可以添加一个“查看详情”控件,在弹出窗口(即模态框)中打开完整的职位信息,用户无需离开聊天。他称这对 Indeed 和聊天平台来说是双赢。他在屏幕上展示了这个小组件;这里的描述依据的是他的口头讲述。
简单照搬的问题:小组件对模型来说成了黑箱
一个诱人的捷径是把 MCP 应用当成把网站搬进聊天的方式:小组件加载一些 HTML,这些 HTML 调用网站现有的 API,就大功告成了。Mihalik 说事情没那么简单,他也见过正是这样构建的 MCP 应用。
问题在于模型知道什么。模型调用工具,工具把结果显示到屏幕上,而模型对这些结果是什么一无所知。于是像“介绍一下第一个结果”或“给这些公司排个名”这样普通的追问就会失败。数据直接从你的 API 流向了小组件,从未经过模型。
规则一:用户看到什么,模型就以数据形式拿到什么
他的第一条规则是:界面中显示的每一条信息,也必须以数据形式提供给模型。
按照他对 MCP 和 MCP Apps 规范的描述,工具响应包含两部分。第一部分是结构化内容(structured content):供模型读取的机器可读结果,也就是纯文本 MCP 工具本来就会返回的内容。第二部分是资源 URI,这是一个指针,聊天客户端通过它加载小组件的 HTML。两者都要返回,而且他说必须保持同步。如果小组件背后的 API 新增了一个字段,比如薪资范围,那么模型读取的结构化内容也应加上同样的字段。否则,用户能看到的某些内容,模型却无从谈起。
防止模型重复输出小组件已经显示的内容
规则一有个副作用。模型拿到数据后,会像对待任何工具输出一样,把整份结果列表用文字写出来——就写在已经显示了这些内容的小组件正下方。用户会把所有内容看两遍。
他的办法是在工具描述(模型据以决定如何使用工具的文本)的开头加一行,说明结果已经以 UI 组件的形式自动展示给用户。他说,有了这一行,模型会写一段简短摘要,把列表交给小组件。他形容界面显示的内容和模型写出的内容之间存在某种拉锯,并说这一行“覆盖了相当多的情况”。
规则二:告诉模型用户点击了什么
小组件还会以另一种方式把信息藏起来。假设一次搜索返回了十个职位,用户打开了其中一个的详情。模型并不知道是哪一个。于是像“为这个职位写一封求职信”或“总结一下这个职位描述”这样的请求就会失败,因为完整的职位信息只加载到了小组件里,从未提供给模型。
Mihalik 的规则是:关于用户在小组件中所做操作的信息,也必须发送给模型。他没有明确说出“规则二”,但它在他的讲述顺序中排第二,而且他后来把数据/渲染分离称为规则三。
他说 MCP Apps 为此提供了一个方法,他称之为 update model context。据他介绍,这个方法只接收一个字符串,所以如果要随时间报告多个事件,就得不断追加到这一个字符串里。他提到了一个据他描述出自 MCP Apps 文档的购物车示例。该应用把购物车中的商品和总价传给模型,因此用户可以就自己的购物车提问。
转折点:UI 工具打断了多步搜索
有了规则一和规则二,模型大致能看到发生了什么。但 Mihalik 说,这个应用仍然不够好,因为人们不会拿简单问题来问 Claude。他说,如果只需要搜索一次,他会直接去网站。他拿给 Claude 的是难题。
他举的例子是一位愿意搬迁的用户。对方希望用同一个职位名称在多个城市搜索,挑出薪资最高的选项,并排除某些行业。他说,如果用的是纯文本 MCP 搜索工具,Claude 处理得很好:它会进行大约 10 到 15 次搜索,筛选结果,提取相关细节,最后给出一张汇总表。这个次数只是一个粗略的例子,并非基准测试。
现在让这个搜索工具同时渲染小组件,并在描述中写明结果会展示给用户。Mihalik 说,Claude 会调用一次就停下,似乎认为结果已经显示在屏幕上,没必要再深挖。他还补充了一个现实原因:没人想看到连续十个轮播卡片,而 Claude 似乎也意识到自己已经展示过内容了。结果,本应改善体验的 UI 反而打断了用户想要的多步工作。他特别说明这是针对 Claude 的情况,是他团队的观察。
规则三:把数据处理和 UI 渲染分开
Mihalik 的第三条规则是把数据处理和 UI 渲染分开,他说这条规则优先于另外两条。他说这一表述取自 OpenAI 的 Apps SDK 文档,并称文档中有好几处提到这一点。
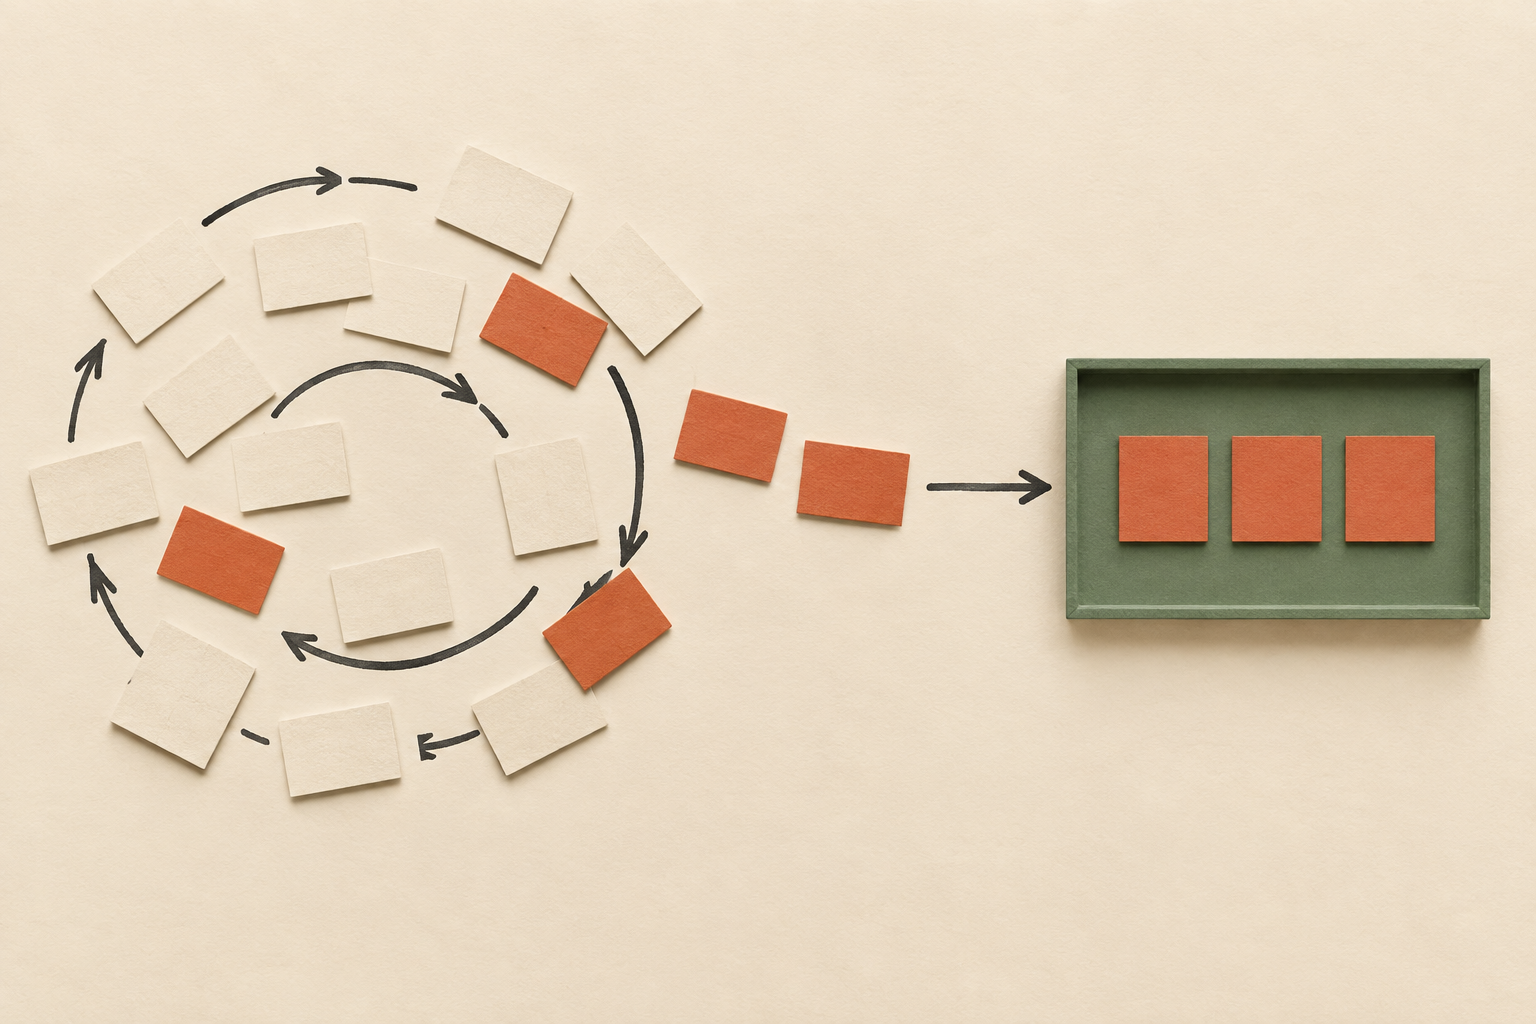
Indeed 的做法是这样的:他称为 search jobs 的工具变成一个标准的纯文本 MCP 工具,没有界面,Claude 想调用多少次都可以。另一个独立的 render-jobs 小组件接收一个职位 ID 列表。Claude 可以先搜索,收集约一百个候选职位,筛选到五个,然后只把这五个 ID 传给渲染工具。用户随后看到的是一个装着模型精选名单的小组件。从一百到五这个数字是他举的例子。
他说,渲染工具既可以接收模型想要展示的完整数据,也可以接收对这些数据的引用。Indeed 选择了引用,也就是 ID。无论哪种方式,渲染工具的描述都必须说明数据从哪里来、必须是什么格式,并说明必须先调用某个数据工具来获取这些数据。他称这只是对工具描述做一处相当简单的修改。
| 同时搜索和渲染的单一工具 | 文本搜索工具 + 独立渲染工具 | |
|---|---|---|
| 模型搜索的次数 | 按他的说法只有一次。模型把已显示的结果当作最终答案 | 按任务需要多次搜索。他描述一个多城市请求会搜索 10–15 次 |
| 模型能看到什么 | 如果遵循了规则一,就是返回的数据 | 在展示任何内容之前,以数据形式看到每一次搜索结果 |
| 用户看到什么 | 由单次查询生成的小组件 | 一个装着模型所选精选名单的小组件(他的例子:约 100 个候选缩减到五个) |
| 渲染步骤接收什么 | 单次查询返回的全部内容 | 模型挑选的职位 ID 列表 |
其他领域的同类拆分,以及承载模型推理的渲染工具
Mihalik 说,大多数行业都能找到类似的拆分方式:先让模型探索数据,再让它选择渲染什么。他提到了电商的商品搜索结果,以及一个接收模型所选五个地址的地图小组件。
接着他提出,渲染工具可以接收的不只是 ID。他指出,在纯文本回答中,模型经常会解释为什么选择每一条结果。渲染工具可以接收一个 ID 加上一句说明该职位为何合适的简短理由,或者一个 ID 加上职位描述中的一段高亮文字。这样,模型的推理就会出现在小组件里,而不是另写一段文字。他说 Indeed“有可能”加入这一功能,所以这些是设计思路,而不是 Indeed 已经上线的功能。
为你自己的 MCP 应用准备的设计清单
Mihalik 以两点收尾。第一,先想清楚数据,再考虑界面。他承认这与把 MCP 应用视为“往 ChatGPT 里放 UI 的手段”这一常见看法相悖。先决定模型应该拥有哪些数据、能用这些数据做什么,再让渲染随着模型对数据的探索自然产生。第二,构建小而可组合的工具。他的例子是:针对不同找职位方式的两三个搜索工具,加上一两个渲染工具,比如一个用于职位列表,一个用于突出显示单个职位。每个工具都配一段简单的描述,这样模型不会不堪重负,同时仍能自己选择如何探索、展示什么。
综合他的建议,可以得到一份给开发者的简短清单。
- 数据一致:小组件显示的一切,也要以结构化数据的形式返回给模型,并且两者保持同步。
- 用描述引导:在工具描述中说明结果已经展示,让模型做摘要而不是重复列出。
- 交互上下文:把小组件内的点击和选择回报给模型,让后续请求有据可依。
- 数据/渲染分离:把搜索做成模型可以多次调用的纯文本工具,只把最终选出的结果交给单独的工具渲染,并在该工具的描述中写明必须先调用哪个数据工具。
尚未证实的部分
这是一个团队在约 15 分钟演讲中分享的经验,没有指标、没有 eval 结果、没有前后对比数据,也没有问答环节。他关于 Claude 何时停止搜索的说法,是对模型行为的观察。这些行为可能会随新模型而变化,在 ChatGPT 或其他客户端中也未必成立——他并没有以同样方式描述这些客户端。
规范术语、update model context 方法及其单字符串限制,以及文档示例,都来自他的描述。我们没有将它们与 MCP Apps 或 Apps SDK 文档核对,也没有构建应用来复现这种行为。请在最新文档中确认确切的字段名和方法名,并把这份清单视为一个论证充分、值得在自己的服务器上测试的起点,而不是经过验证的方案。
来源
相关来源
资料与编写依据
我们通读了这段约 15 分钟的 AI Engineer 录像的完整英文自动生成字幕,从自我介绍到结束语。录像中没有问答环节。屏幕上的幻灯片和截图无法获取,只能通过演讲者口头所述来描述。含混不清的字幕片段要么做了保守处理,要么予以略去。我们没有查阅 MCP、MCP Apps 或 OpenAI Apps SDK 的官方文档,也没有为本文构建或测试任何 MCP 应用。